无标题
Agent Harness 工程 vs. 循环工程 vs. 图工程
导读: AI Agent 领域有三个长得像、经常被混用的词:Harness Engineering、Loop Engineering、Graph Engineering。一句话记住它们的分工:Harness 管环境,Loop 管反馈,Graph 管流程。
30 秒先分清三个概念
裸的大模型只做一件事:接收输入,产出输出。它不会保存项目状态,不会打开浏览器,不会跑测试,也判断不了一次失败之后该重试还是该叫人。
Agent 之所以能真正干活,靠的是包在模型外面的一整套系统。麻烦在于,这套系统里风格各异的设计,经常被一股脑塞进”Agent 编排”这个筐里。
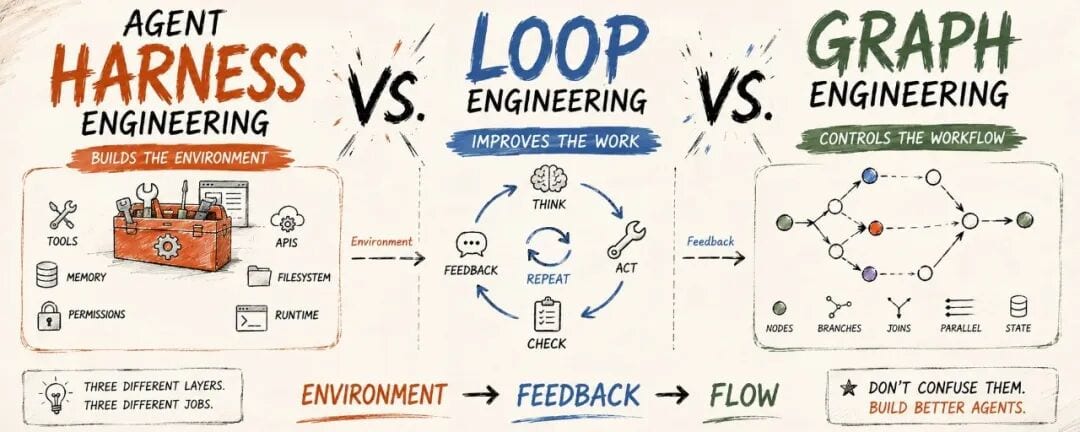
三层的边界可以这样划:
| 层 | 回答的问题 | 典型组成 |
|---|---|---|
| Harness Engineering | 模型在什么环境里工作 | 工具、文件系统、记忆、权限、沙箱、日志、模型路由 |
| Loop Engineering | 做完一轮之后怎么办 | 证据、反馈、重试、预算、停止条件、人工复核 |
| Graph Engineering | 下一步允许谁运行 | 节点、边、分支、并行、汇合、状态迁移、受控循环 |
注意三层之间是互相嵌套的:Harness 里可以跑一张 Graph,Graph 的某个节点里又可以套一个验证 Loop。它们不是物理上隔开的三块,而是三个不同的工程抓手。
Harness:给模型搭一套能干活的环境
LangChain 在 2026 年 3 月的定义很直白:Agent = Model + Harness。模型之外的一切代码、配置和执行逻辑,都算 Harness。
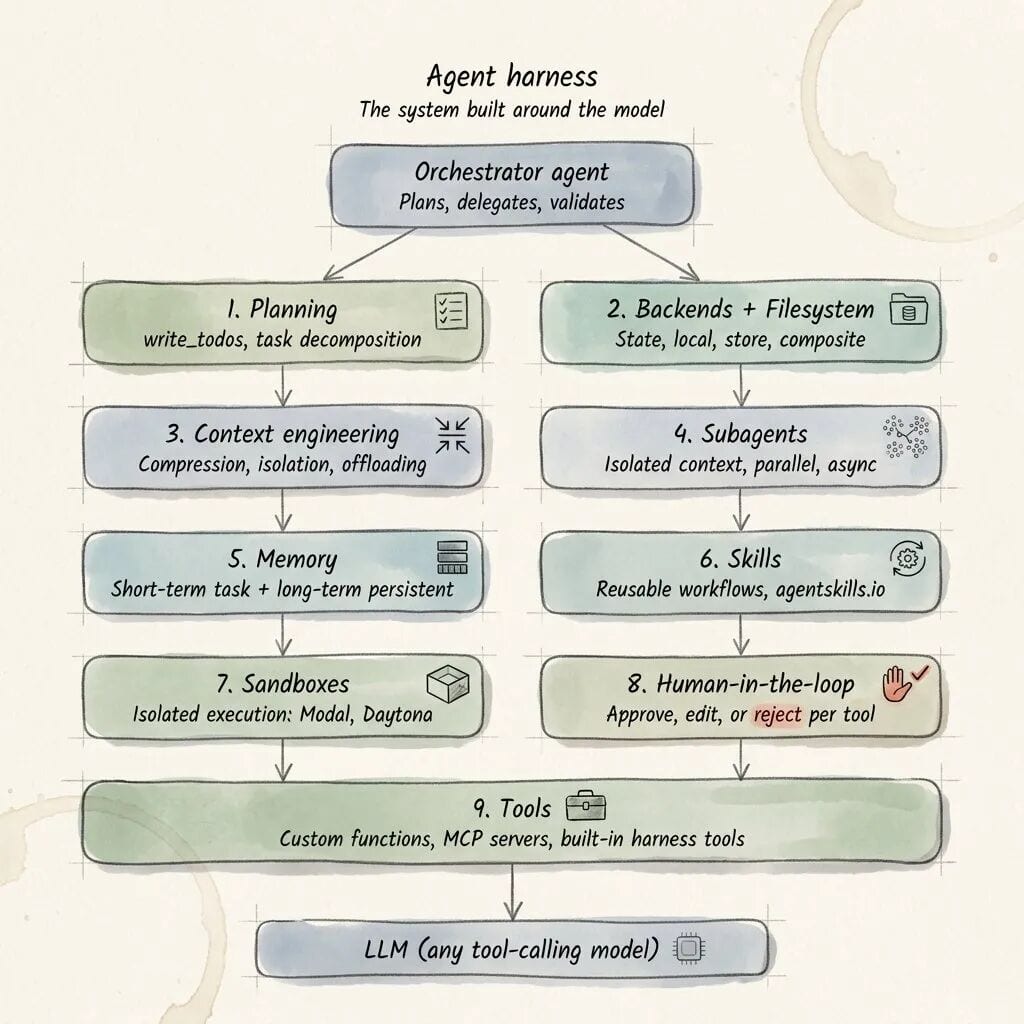
要让 Agent 稳定干活,Harness 里六类东西缺一不可:
- 上下文:系统指令、检索结果、对话状态、Skills、任务规则。
- 行动入口:API、浏览器、Shell、数据库、代码解释器、MCP 工具。
- 持久化:文件、检查点、会话、进度日志、Git 历史、长期记忆。
- 执行控制:超时、预算、模型路由、子 Agent、审批门、重试上限。
- 安全边界:权限、隔离、白名单、密钥处理、人工授权。
- 可观测性:工具输入输出、状态变化、延迟、成本、Trace、评测结果。
一个实用的判断方法:把架构图里的模型拿掉,剩下的工具、状态、沙箱、中间件、评测器和 UI,基本都属于 Harness。
这也解释了一个常见现象:同一个底座模型,装进两套系统表现天差地别。模型能力差不多,一边有干净的工具契约、稳定的工作区、受限的权限和可追踪的状态,另一边只有一段模糊的提示词加一层不稳定的 API 包装——差距往往出在工作条件上。
Harness 的问题最容易在长任务里暴露。Agent 一旦要跨会话干活,光压缩上下文是不够的,还需要进度文件、可恢复状态、Git 历史,以及一套能让下一次运行知道”做到了哪、还剩什么”的交接规则。
所以:Agent 缺能力、丢状态、权限过宽、无法审计,或者换个环境表现就不一致——先修 Harness,别急着怪模型。
Loop:别让 Agent 凭感觉宣布完成
只要 Agent 会调工具,它内部天然就有一个小循环:模型决策 → 工具执行 → 结果回到上下文 → 再决策。Loop Engineering 要做的,是在这个小循环外面,加上更可靠的反馈和终止机制。
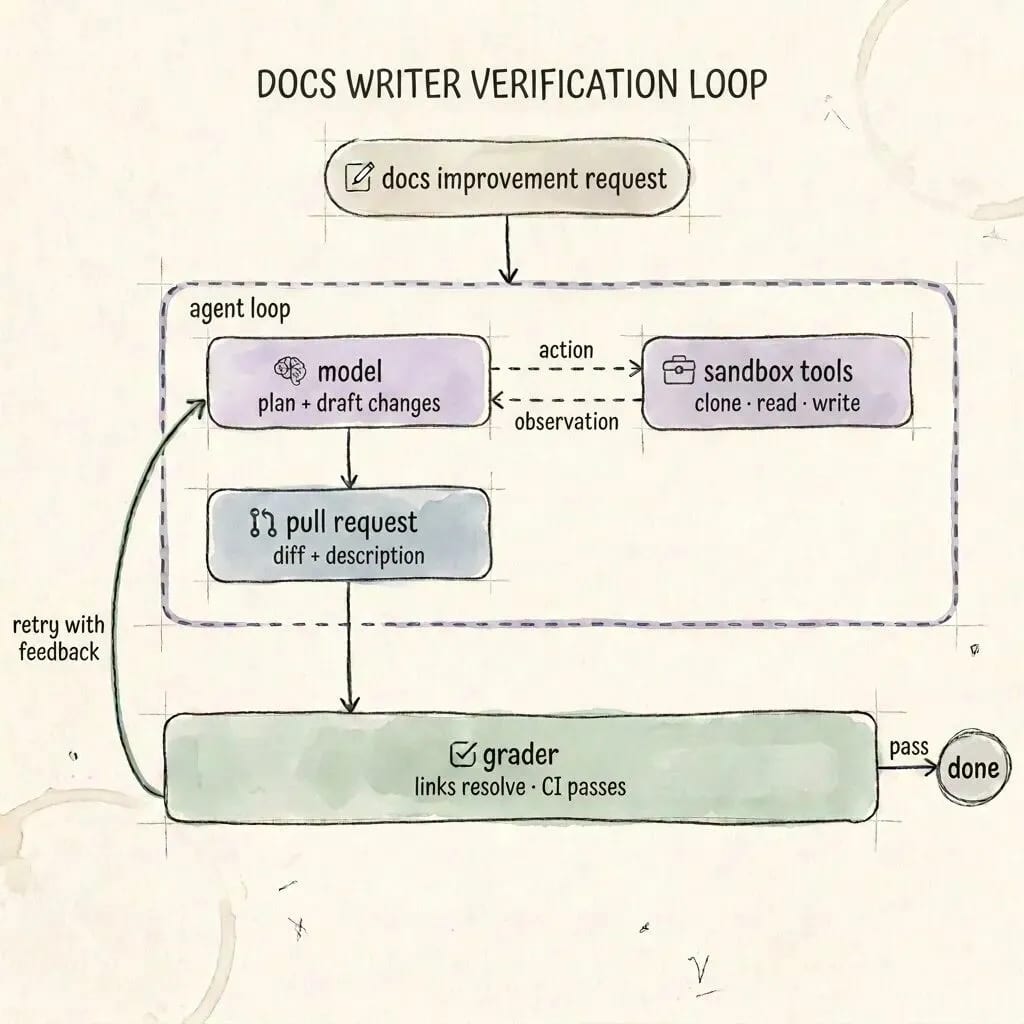
举个例子:一个文档 Agent 先改内容、提交 PR,然后由外部检查器验证链接、CI 和改动范围。检查不过,具体错误退回去改;全部通过,才算结束。
一个能上线的 Loop,至少要把这些写清楚:
- 什么事件触发下一轮;
- 这一轮要达到哪个具体状态;
- 下一轮要继承哪些状态;
- Agent 可以调用什么、修改什么、花多少;
- 用什么证明成功——测试、Schema、引用、Diff、指标,还是人工审核;
- 失败反馈怎么压缩成可执行的信息;
- 什么时候算成功,什么时候因为预算、超时或不可恢复错误退出。
整个 Loop Engineering 最核心的一句话:不要围绕”信心”循环,要围绕”证据”循环。
“Agent 说自己做完了”不是停止条件;”测试通过、链接可访问、Schema 校验成功、审核人批准”才是。
这也是 Loop Engineering 和 Prompt Engineering 的分界线:Prompt 决定单次模型调用内怎么做;Loop 决定调用结束之后,系统怎么观察结果、生成反馈、保存进度,以及要不要继续。
另外,Loop 不是越多越好。每加一个评分器、复核者或重试,都在加成本和延迟。只有当失败的代价高于验证的代价时,这个 Loop 才值得加。
Graph:把”谁先谁后”写成明规则
Graph Engineering 关心的是另一个问题:当前节点跑完之后,哪个组件被允许运行?
在工作流图里,节点可以是确定性函数、一次模型调用、一个专业 Agent,也可以是人工审批;边则规定顺序、条件分支、并行展开、汇合、回退和退出。
图不难画,难的是这些决策:
- 哪些活交给函数,哪些交给模型或人工;
- 每个节点能读写哪些状态;
- 并行结果冲突了怎么合并;
- 什么证据让流程前进、回退或升级;
- 哪些步骤能并行,哪些必须等汇合;
- 哪里允许循环、最多几次、怎么安全退出;
- 检查点存在哪,任务中断后从哪恢复。
微软 AutoGen 的 GraphFlow 文档给了一条很克制的适用边界:只有当流程需要严格控制执行顺序、按不同结果走不同分支,或者包含复杂多步骤循环时,才值得上 Graph。如果任务简单到只是”给一个 Agent 三个工具”,硬画成图反而可能更脆。
还有一个常见误会要说清:这里的 Graph 指执行图,表达的是控制流和状态迁移,不是知识图谱。前者回答”下一步跑谁”,后者回答”数据里的实体之间有什么关系”。
出了什么故障,就改哪一层
这三个词更实用的用法,是当成一张排障地图。Agent 出问题时,先定位故障属于哪一层,往往比先挑框架更有用。
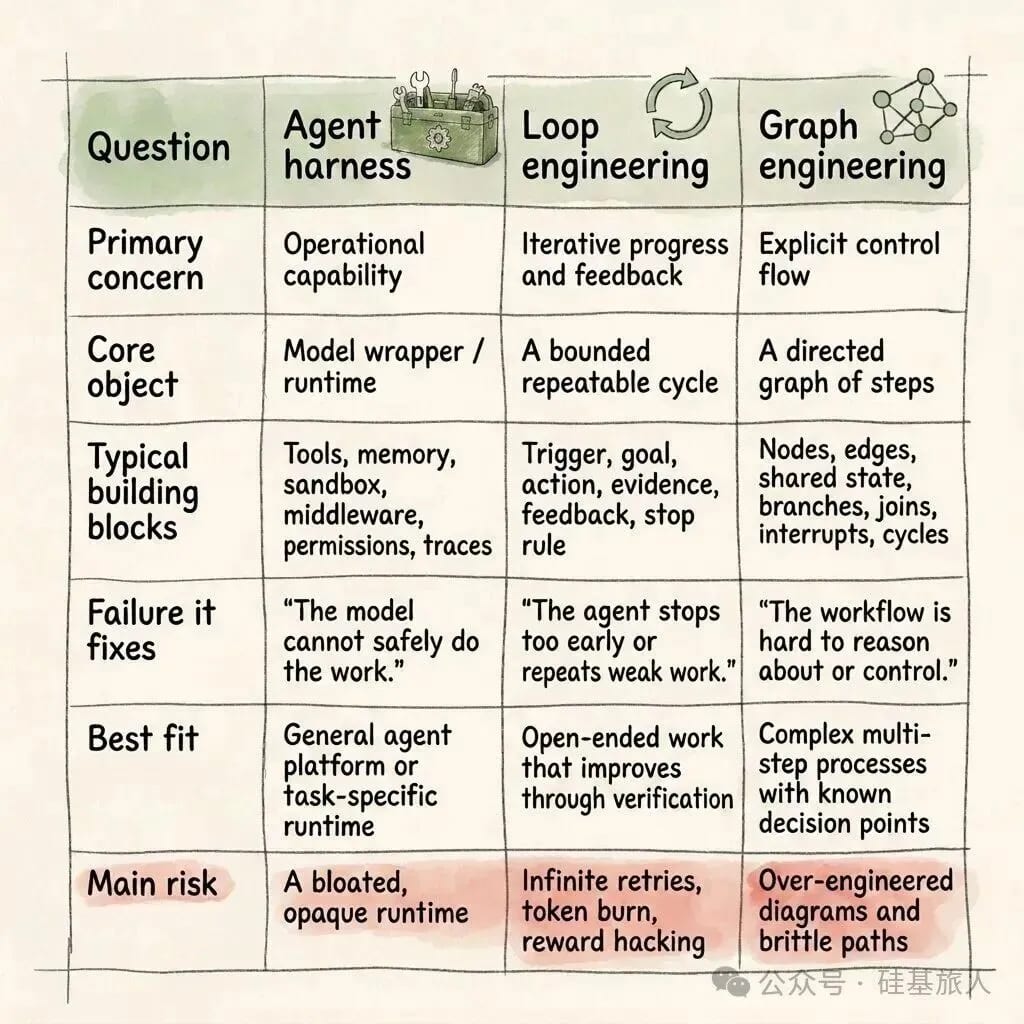
判断口诀:Agent 拿不到正确数据、工具权限太宽——问题在 Harness;第一次结果总是差一口气——补一个带证据的验证 Loop;多个专业 Agent 的顺序、分支、汇合已经追踪不过来——再把稳定路径固化成 Graph。
一个研究与出版 Agent 能把三层全用上:
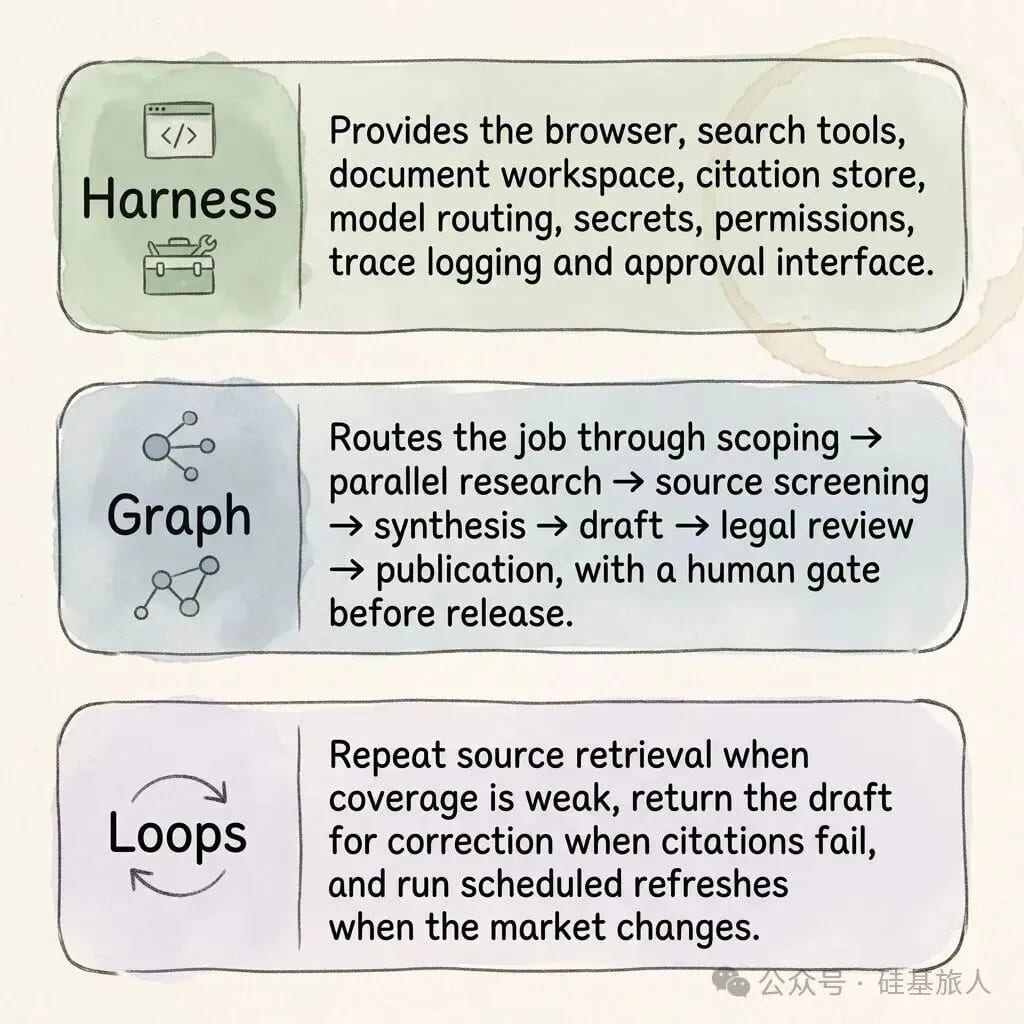
Harness 提供浏览器、搜索、文档空间、引用库、权限和日志;Graph 安排选题、并行研究、信源筛选、写作、法务审核到发布;Loop 在信源覆盖不足时重新检索、在引用校验失败时退回修改。
最贵的错误,基本也都能沿三层找到影子:
- 还没观察清楚 Agent 实际怎么做事,就先画出几十个节点;
- 让同一个模型既写作又评分,却没有确定性检查和人工兜底;
- 把”继续尝试”当循环规则,没有目标、证据、次数上限和升级路径;
- 不停往 Harness 里塞工具和记忆,结果选择错误更多、上下文更吵、权限风险更大;
- 明明是状态、工具契约或退出条件坏了,却把锅全甩给模型。
所以,先别问”要不要上 Graph”,先问 Agent 为什么失败:缺环境,修 Harness;缺反馈,修 Loop;缺流程控制,再上 Graph。环境 → 反馈 → 流程——这条顺序,比记住三个新名词更值得。
 微信
 支付宝